先说个不太中听的事实:一个真有优势的策略,照样能把账户亏到归零。
大多数爆仓不是输在没优势,是输在执行——单笔下太重,或者策略其实早就死了,人还在硬扛。Edgekit 是我写的一个小库,就管这两件事:手里有个优势,该押多重;以及,什么时候该承认它没了。
它不帮你找优势。优势是你自己带进来的,库只负责把它安全地用掉、并在它失效时叫停。
正期望,不等于能活下来
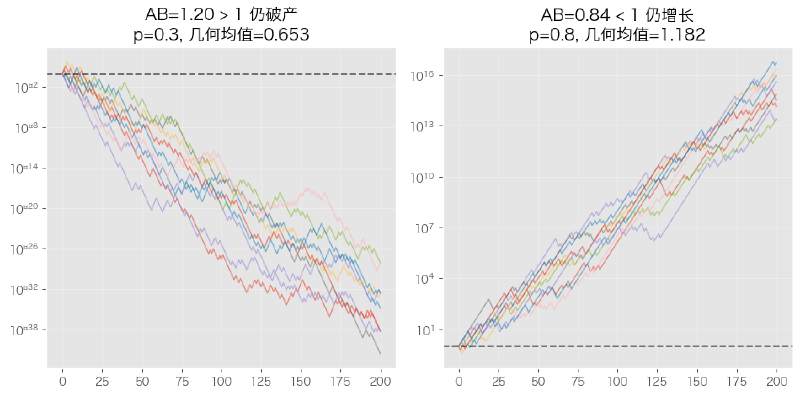
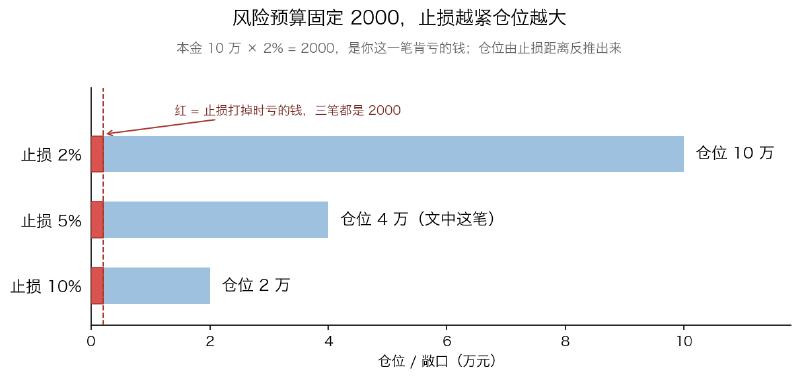
把交易抽到最简单:抛硬币。赢了资本乘以 $A$($A>1$),输了乘以 $B$($0 只看期望的话,$A+B>2$ 这个游戏就该玩——单轮平均是赚的。大部分人就是被这个数字勾进场的。可它是个陷阱。账户是个乘法过程,决定你长期死活的不是和,是积。五五开的时候,真正的生死线是 $AB>1$: 真实交易当然不是五五开。而一旦 $p \neq 0.5$,连 $AB$ 都不管用了。下面两条路径很说明问题:一个 $AB=1.20>1$ 的组合最后破产,一个 $AB=0.84<1$ 的组合反而稳稳往上走。 真正决定命运的,是按概率加权的几何平均: $A+B>2$ 让你想玩,$A^{p}B^{1-p}>1$ 才决定你能不能留在牌桌上。前者制造希望,后者决定命运。 翻回交易语言:$A$ 是赢时的增长乘数(盈亏比和风险比例定的),$B$ 是输时还剩多少(也就是 1 减去风险比例)。很多人死盯盈亏比、拼命要大的 $A$,却让风险比例失控、把 $B$ 压得太小,结果 $g<0$,越做越穷。Edgekit 整个库,就是为了管理这个乘法过程而存在的。 它的逻辑是 (参数) → (决策):你给它带样本量的胜率和盈亏比,它给你执行决策。它不碰市场数据,也不替你找机会。两个问题而已: 反过来,它刻意什么都不做:不是自动交易系统(不下单、不连交易所),不是策略发现系统,不做回测,不碰机器学习。这些"不做"恰恰是它的定位——只占执行和风控这一小块,然后把这块做干净。 打个比方:优势是发动机,Edgekit 是变速箱和刹车。发动机得是真的,变速箱才有意义;可发动机再好,没刹车迟早出事。 整个库里,“风险"只有一个含义: 风险 = 止损被打掉的时候,账户最多亏多少钱,用本金的百分比表示。 2% 就是"这一笔最多亏掉本金的 2%"。它不是仓位大小,不是保证金,也不是杠杆。 这条定义是整个系统的地基。把风险跟具体品种的波动脱钩之后,同一套资金管理才能套到任何品种上。仓位不是你想下几手就几手——先定死这一笔肯亏多少(本金 10 万、认 2%,就是 2000),再看止损画在哪,仓位就被这两个数反推出来: 杠杆和合约乘数只是换算口径,改的是保证金和张数,并不会放大止损时的亏损敞口。敞口不变,这条风险定义就不破。 这是 solver 的活。喂给它的不是"胜率 0.6"这种光秃秃的数字,而是带样本量的证据:100 笔里赢了 60 笔,盈亏比 1.5。为什么非要样本量?因为胜率是估出来的,样本越少越不可靠。它代进凯利公式的也不是你估的那个值,而是它的置信下限——可以理解成"按这点样本,保守说至少有多少胜率”。样本少,下限压得低,结果就保守;样本攒多了,下限自然往点估计靠。 风险比例要过三道关: 三关下来,你拿到的是一个保守、可解释、能审计的单笔风险比例。 每平一笔,就把这笔的盈亏喂给 monitor,让它判断当初那个优势还在不在。 第一件得想明白的事:亏损不等于失效。正期望的系统照样会连亏、会深度回撤,那多半只是方差。失效是另一回事——是实际结果已经不像从你当初假设的那个分布里出来的了,是结构性的偏离。 它布了两道彼此独立的防线,任何一道触发就停,不用另一道点头: 这里有个刻意的不对称:停的门槛低,继续的门槛高。单独一条证据就够触发停止;“多方证据互相印证再动手"那种谨慎,只准用在"继续做"这个方向上。道理不复杂——该停没停,亏掉的本金回不来;不该停却停了,损失的只是机会,还能再来。宁可多停,不可漏停。停了之后没有自动恢复,想重启得人工复核、用新的基线参数签一份新 policy。 这其实是 Edgekit 最值钱的地方:它把"我到底还有没有优势"从一个玄学问题,变成一个可证伪的命题。不用它,亏钱之后你永远分不清是运气差还是方法错,只能在"再扛扛"和"换打法"之间反复横跳。用它,每一次失败都收敛成一个干净的结论,而且这一笔最多亏多少,事先就摆在那儿。 丑话得说前头。Edgekit 最重要的一条承重假设是:置信下限只能补偿"样本太少"这一种毛病。回测过拟合、幸存者偏差、市场结构变了——它一概管不了。换句话说,库会把"你以为的优势"当真去用,至于这个"以为"靠不靠谱,得你自己保证。垃圾进,垃圾出,输出质量的上限由输入质量决定。 还有几条前提,塌一条结论就跟着塌:止损得真能成交(跳空、闪崩时实际亏损会超出风险比例,杠杆还会再放大);输入得是净口径(扣干净滑点和手续费,用毛数字所有结论都偏乐观);模拟默认每笔交易相互独立(趋势类策略盈亏成串,独立假设会低估风险)。 把边界这样明明白白写出来,本身就是它的一个卖点——它清楚地告诉你,它会在哪儿失灵。 核心是纯函数:不读文件、不连网络、core 层不碰随机数,同样的输入永远给同样的输出,每一步都能手工复算、能审计、能复现。Python 写的,设计成被别的系统调用——交易系统、策略框架,或者 AI agent。 完整的数学推导、API、还有一份手把手的实战指南,都在 edgekit.fists.cc。最后借它的使命宣言收尾,这也是整个库的全部野心: 这个库假设优势是存在的。
它从不尝试寻找优势。
它只决定如何使用它——以及何时停止。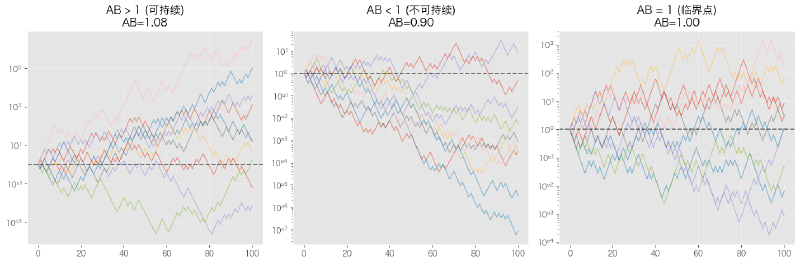
它只做两件事
风险只有一个意思
开仓前:该下多重
平仓后:还活着吗
它不替你保证什么
哪儿能拿到