#13 Memory Networks 里 attention 干的是挑:拿问题去跟每条事实比一比,挑出该读的那条,多跳就是顺着挑好几次。从 #09 Bahdanau 起,这一整条线都在把「挑」做得更软、更可微。
Santoro 那帮人 2017 年的 A simple neural network module for relational reasoning(模型常被叫 Relation Network,下面简称 RN)问了句反过来的话:能不能不挑?它的答案是不挑。把每一对对象 (o_i, o_j) 都丢进同一个小网络 g,全部加起来,再用 f 从这个和里读出答案:
没有 attention 权重,没有路由,没有谁比谁重要。所有对一视同仁,各算一遍,求和。听着挺笨,但这一笨恰好是后来 self-attention 的骨架——self-attention 不过是把这个等权的和换成了 softmax 加权的和。
为什么求和就够
三件事撑着这个模块。一个 relation 本来就是「两个对象的函数」,同一个 g 用在每一对上,参数省,还逼着模型把关系当成通用的东西,而不是给每对配一套。一堆对象本来没有先后,先求和再读出,意味着打乱顺序结果一个字都不变——置换不变是白送的。问题 q 拼进每一对里,g 看到的是 (o_i, o_j, q),于是「关心哪种关系」由问题说了算。
读出那一步就是过个 f 再 softmax,
跟 #12 NTM 那套 location addressing、erase/add 比,这里干净得不像话:两个 MLP,一次求和。论文标题里的 simple 不是谦虚。
最近邻的颜色
得有个非用上关系不可的任务。我把对象摆在一条线上,每个对象一个颜色、一个位置,问:离 c 这个颜色最近的,是什么颜色?
位置:  0      2      3      4      5
颜色: blue  green   red  orange purple
Q: 离 blue 最近的是什么颜色?  ->  green
答对必须把两个对象的属性绑一块:c 在哪、别人在哪、别人什么颜色。单看任何一个对象都没用。颜色在每个场景里都不重复,直方图永远是平的,没有「猜最常见那个」的捷径,瞎猜就是 1/5。
纯 NumPy 写的 g、f,手推 backprop,有限差分梯度检验中位相对误差 1.2e-6,Adam 训 50 个 epoch,RN 测试准确率 0.981。
没人告诉它该看 c 和最近那个对象。训练时只给问题和答案,没标「这道题靠第 0 个和第 2 个对象」。这条成对的关系是从问答对里自己长出来的,跟前面几篇一样,端到端。
它学会了,可惜没赢
这里得说点实话。同一个任务、同一套训练,四个模型只差在架构上。
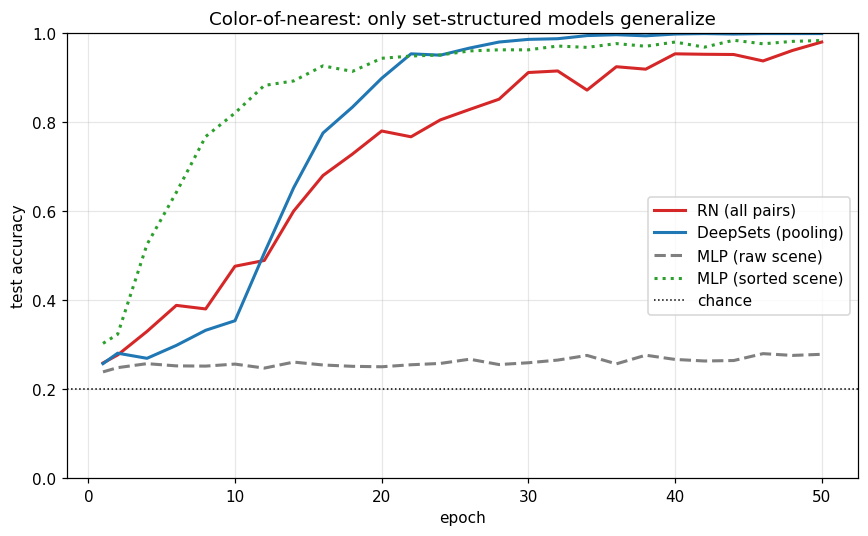
一个普通 MLP,把整个场景拍平喂进去(对象按原始顺序排):训练 0.827,测试 0.279。它在背训练集里对象的排列方式,没学会「这是一个集合」,一到测试就崩回瞎猜附近。
但凡把场景当集合看的,都学得会:RN 0.981,给同一个 MLP 喂一个固定排好序的场景也能到 0.984。所以这个 demo 里真正的分水岭,是有没有把输入当集合处理。RN 用 all-pairs 加求和,把这件事直接内建了——打乱对象顺序,输出只变 2.8e-14,浮点噪声级别。
更得说实话的是另一头。在这么小的任务上,连不配对、只做 pooling 的 DeepSets(f(Σ_i g(o_i, q)),一点成对计算都没有)都能训到 1.000,比 RN 还好。pairwise 这层结构在这个玩具上根本不是必需的。它是给更难的关系留的保险:论文在 CLEVR 上(带视觉、问题更绕),普通 MLP 只有约 63%,RN 到约 94%,那个差距才是 all-pairs 真正挣出来的。换句话说,这篇 demo 能让你看清 RN 长什么样、为什么置换不变、学到了什么,但它比基线强多少,得换个更难的舞台。这点跟 #12 NTM 一个味道——机制漂亮,好处要到够难的问题上才兑现。
算了所有对,只有一对在干活
RN 把 5×5=25 对全算了。哪些对真在影响答案?做个 ablation:把某一对从求和里拿掉,看正确答案的 logit 掉多少,掉得越多越重要。
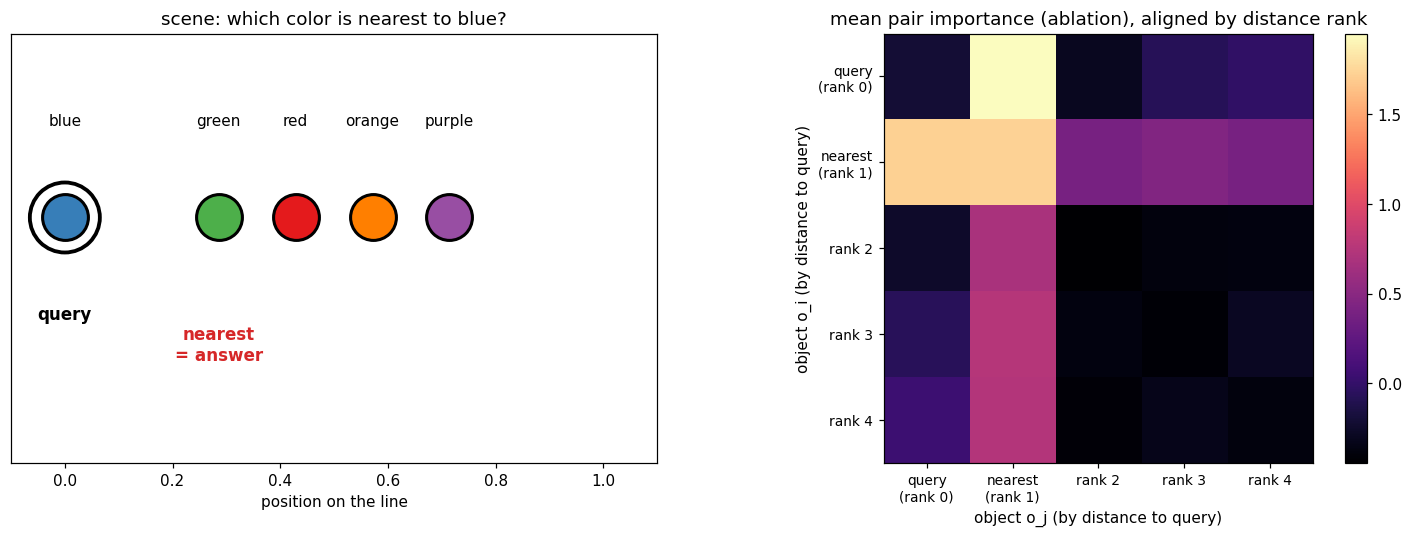
把每个场景按「到 c 的距离排名」对齐(rank 0 是 c 自己,rank 1 是最近邻,往后越来越远)再平均,右图最亮的格子就是 query × nearest 这一对。全测试集上看,最重要的那一对有 90.8% 涉及最近邻那个对象。
算了所有对,但承载答案的就是 c 跟它最近邻这一对。RN 没有 attention 那样显式地挑,可它学出来的效果,是让无关的对在求和里互相抵消、让相关那一对冒头。这张图跟 #13 那张 attention 落点图说的是同一件事,只不过一个是挑出来给你看,一个是全算完自己浮出来。
往后
把 RN 摆在 attention 旁边,形状几乎重合:都是在一组对象上,对每一对做点什么,再聚合。RN 是每一对过共享 g、等权求和;self-attention 是每一对做点积、softmax 加权求和。RN 就是「所有对、不加权」那版,attention 把权重又加了回来。顺着看很清楚:#13 的 attention 是加权地挑,RN 是不加权地全算,Transformer 的 self-attention 是在所有对上做带学习权重的聚合,正好是这两者的合体。RN 这一篇的价值,是把「对一个集合里所有对象两两交互」这个想法剥到了最干净。
往应用那头,两条线在收口:#13 那条 content-addressed read 通向检索增强(RAG);RN 这条 all-pairs interaction 通向 self-attention。Pointer、NTM、Memory Networks、Relation Networks 这几篇 2015–2017 的 attention 变体,最后大多被 Transformer 一个结构吸收了进去。
代码
完整 notebook 在 ZhenchongLi/sutskever-30-reading,在原来只有前向、未训练的 16_relational_reasoning.ipynb 上扩出训练后重跑的版本,文件 16_relational_reasoning_rerun_20260605.ipynb。里面跑了五件事:一维最近邻问答任务;纯 NumPy 实现 RN(共享 g 跑所有对、求和、f 读出,带手推 backprop 的梯度检验);训 RN 和三个基线(DeepSets、原始顺序 MLP、排序后 MLP)比准确率;验证置换不变性;用 ablation 量每一对的重要性,按距离排名对齐看哪些对承载答案。
Run Metadata
- repo: ZhenchongLi/sutskever-30-reading
- notebook:
16_relational_reasoning_rerun_20260605.ipynb(在16_relational_reasoning.ipynb基础上加训练后重跑) - 2026-06-05 执行通过(
jupyter nbconvert --to notebook --execute --ExecutePreprocessor.timeout=300),无报错 - 关键输出:梯度检验中位相对误差 1.2e-6;测试准确率 RN 0.981 / DeepSets 1.000 / 原始顺序 MLP 0.279 / 排序 MLP 0.984(瞎猜 0.20,majority 0.171);置换不变性 max|Δlogit| = 2.8e-14;最重要的对涉及最近邻的比例 0.908
- Python 3.13.2 / NumPy 2.4.4 / Matplotlib 3.10.8
怎么跑
cd ~/code/sutskever-30-implementations
jupyter lab 16_relational_reasoning_rerun_20260605.ipynb
选 kernel Python (sutskever-30)。
备注
- Santoro, Raposo, Barrett, Malinowski, Pascanu, Battaglia, Lillicrap 2017 A simple neural network module for relational reasoning(NeurIPS 2017,arXiv 1706.01427)是原始论文,模型常被叫 Relation Network(RN)
- 原论文在 CLEVR(视觉问答)、Sort-of-CLEVR、bAbI 上验证:对象是 CNN feature map 的格子,或 LSTM 编码的句子,问题用 LSTM 编码。这篇是最小版——对象是
(位置, 颜色)、问题 one-hot、任务合成、摆在一维线上,好让纯 NumPy 的小模型干净地收敛 - 任务用「最近邻的颜色」而不是论文那种「最近邻的形状」,是因为颜色在每个场景里唯一、直方图平,没有「猜最常见」的捷径;问形状的话基线能靠形状直方图蒙到约 0.5,把关系信号盖掉
- 普通 MLP 在这个 demo 上崩,主要是它对对象顺序敏感(不置换不变)——把场景按颜色排好序,同一个 MLP 就回到 0.98。论文的 MLP 基线在更难的 CLEVR 上崩,那才是关系推理本身的难度
- DeepSets(Zaheer et al. 2017)是 sum-pooling 的通用集合函数逼近器,在这个玩具上够用甚至更好;RN 多出来的成对结构,是留给更复杂关系的
- 一条线串下来:Pointer Networks(#10) 让 attention 当输出,NTM(#12) 让 attention 读写一块 memory,Memory Networks(#13) 砍到只读、多跳,Relation Networks 把「挑」也砍了、改成所有对等权算一遍。content-addressed read 这条通向 RAG,all-pairs interaction 这条通向 Transformer 的 self-attention
$$\text{article}^* = \underset{\theta}{\arg\min}\ \mathcal{L}_{\text{lizcc}}(\theta), \quad \theta \in \lbrace\text{Joe, Weaver, Ruyi, Thorn}\rbrace$$